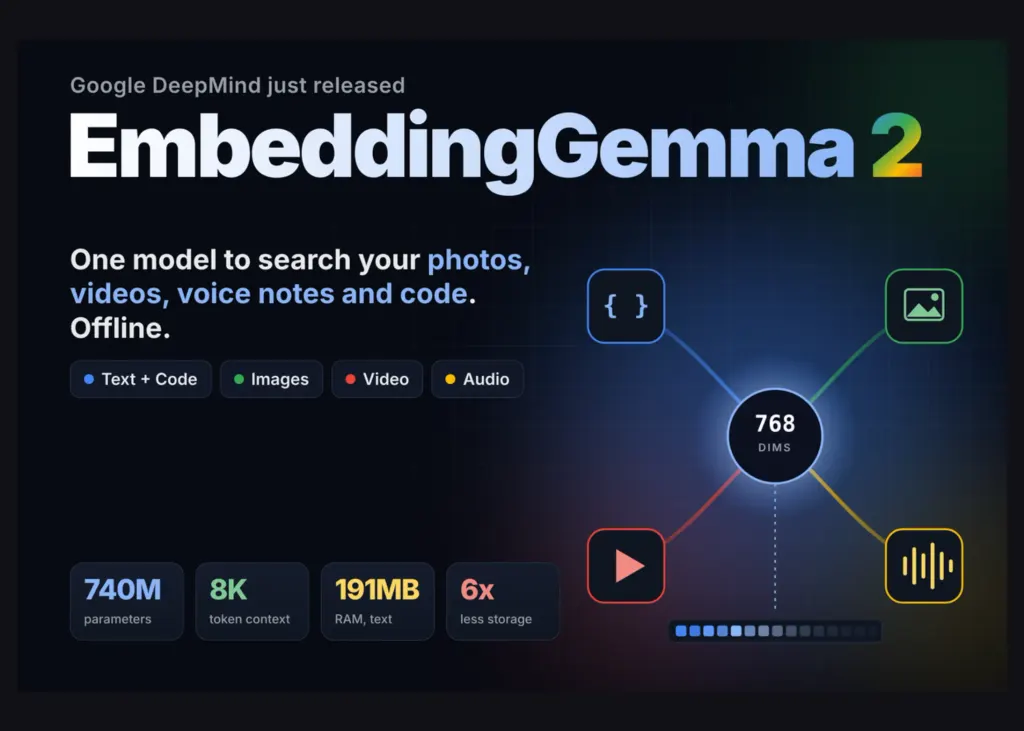
谷歌DeepMind发布EmbeddingGemma 2:基于Gemma 4的7.4亿参数开源多模态嵌入模型
谷歌DeepMind发布开源模型EmbeddingGemma 2,可将文本、代码、图像、视频和音频嵌入同一个768维向量空间。该模型拥有7.4亿参数、8K令牌上下文窗口,采用Apache 2.0许可证,主要面向端侧搜索、分类以及注重隐私的检索增强生成(RAG)场景。模型目前已可部署,权重已在Hugging Face和Kaggle上线,并提供Ollama、llama.cpp GGUF和LiteRT版本。嵌入模型的作用是把内容转换为能够表征语义的数值向量,相似内容在向量空间中彼此接近,便于搜索和比较。在RAG流程中,这些向量可帮助大语言模型检索训练时未接触过的新信息;在本地生成嵌入则能让数据留在设备上,降低延迟并支持离线使用。EmbeddingGemma 2基于Gemma 4架构,所有模态共享同一向量空间,因此文本查询可以检索照片,语音备忘录可以检索视频片段;包含文字、图片和演示视频的商品页面等交错输入,也能生成单一嵌入。该模型采用模块化设计,由三部分组成:2.7亿参数的文本与代码主干(其中Transformer部分1.3亿参数、嵌入层1.4亿参数),以及可选的1.7亿参数视觉编码器和可选的3亿参数音频编码器。