qwenGPU发布:把45层编译GPU塞进Qwen3.5-2B权重并跑CUDA
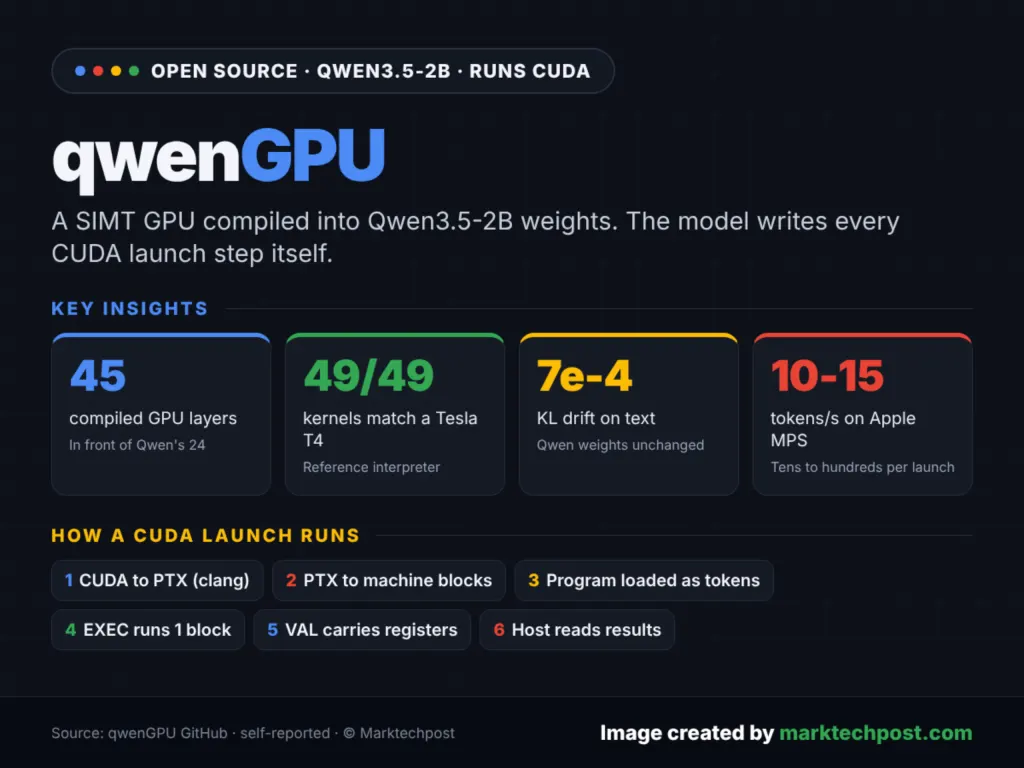
开发者Vixhal(@TheVixhal)以MIT许可在GitHub发布实验模型qwenGPU:它把SIMT GPU直接编译进Qwen3.5-2B的权重里,在自身前向传播中运行编译到NVIDIA PTX的真实CUDA,用以检验精确计算能否嵌在预训练大语言模型内部而非旁路。规模为Qwen3.5-2B的24层再加45层编译出的GPU层,共69层;上下文长度沿用基座的262144个token。可在Apple芯片、NVIDIA GPU或CPU上运行,约需16GB空闲内存,尚无量化版。开发者实测每次启动结果精确,文本漂移KL约7e-4;参考解释器在49个内核上与真实NVIDIA Tesla T4全部一致。短板包括Apple MPS上约每秒10到15个token,以及由Qwen写出的CUDA仅通过5项中的4项。这45层均未训练,权重由编译器计算得出,并置于Qwen原有24层之前。
编号 NEWS-20590
分类人工智能
时间2026-11-02 17:18:00
相关10