一只鹈鹕,骑走了我的 AI 周额度
冲着 Gemini 4 Argon 订了一年 Pro,没想到先被会员权限上了一课。鹈鹕测试挺惊艳,真正用 Antigravity 跑大型任务,却直接烧光了周额度。聊聊 Codex、Opus、Grok 和 Argon 的真实使用体验,以及 AI 编程工具那些让人哭笑不得的瞬间。
半梦半醒买了一年 Gemini Pro,清醒之后,发现事情没那么简单。
人最好不要在刚睡醒的时候做任何重大决定。
尤其是涉及信用卡的。
前几天,睡眼惺忪地刷到一条消息:Google 的 Gemini 4 Argon 终于开放使用了。
Argon 我之前就一直想试试,毕竟各种评测看起来都挺厉害。当时脑子还没完全清醒,随手点进 Google 的订阅页面,赫然看见一个 Special Discount。
折扣这东西很奇妙。原本还在考虑要不要买,一看到折扣,就开始担心不买会不会吃亏。
于是我非常果断地替未来一年的自己做了决定:Gemini Pro,年付。
付款成功,安心睡觉。
等再次醒来,准备好好享受一下刚买的生产力,更新 Antigravity,打开模型列表。
嗯?
Argon 呢?
再仔细一看,原来 Argon 当时在 Antigravity 里只对 Ultra 用户开放。
我买的是 Pro。
不能说 Google 骗了我,人家确实开放了,只是没完全开放给我。
这感觉就像冲着酒店广告上的顶楼无边泳池订了房,兴冲冲换好泳裤、坐电梯上去,才发现泳池只对总统套房的客人开放。
房间倒是订成功了,浴袍也挺舒服,就是我想游的那个泳池,跟我没什么关系。
算了,反正会员买都买了。至少今年不用再纠结要不要订 Gemini Pro。
毕竟已经没有选择了。
鹈鹕让我重新燃起了希望
没想到 Google 这次动作还挺快。
就在今天,Antigravity 突然提示 Argon 已经可以用了。打开一看,Pro 用户也能选,之前那点小小的不愉快瞬间烟消云散。
人就是这么没出息。
更巧的是,我的 Codex usage 刚好见底,weekly reset 还没到。平时常用的 GPT-6.1 Sol XH 暂时指望不上,正好轮到新同事上场。
我决定先跑个鹈鹕测试。
结果出乎意料地不错。
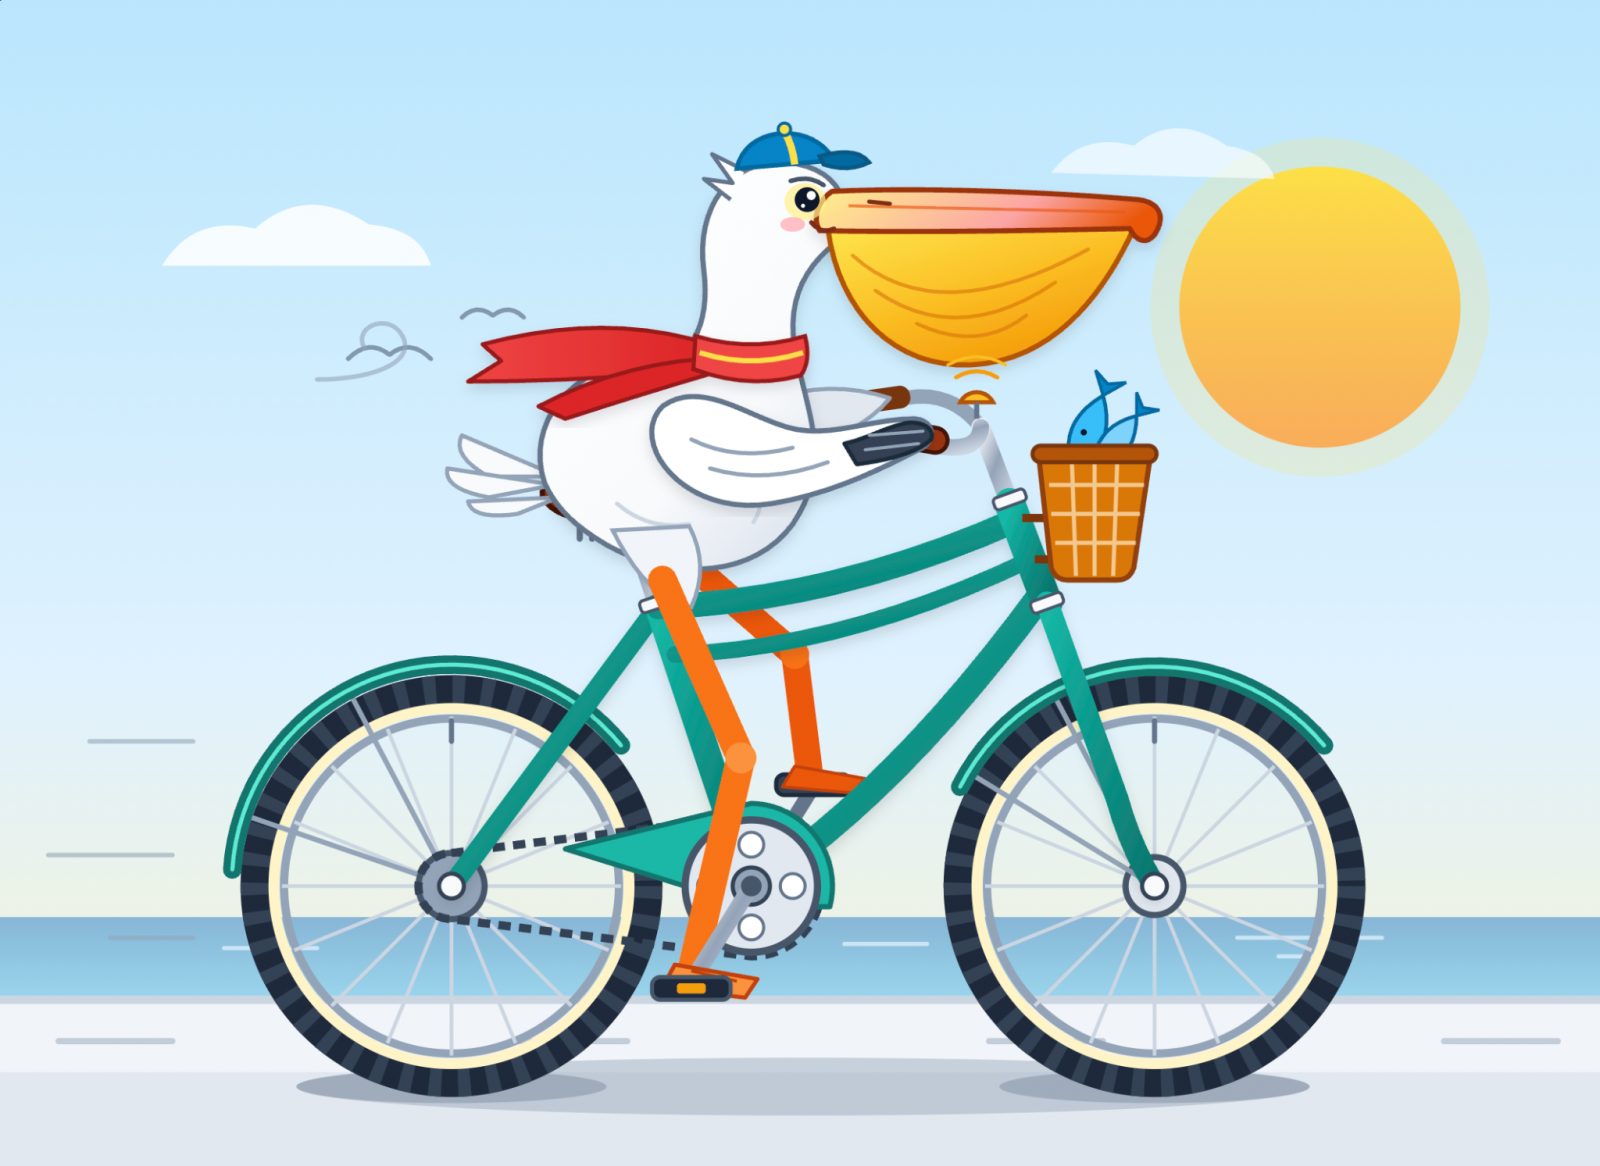
一只大嘴鹈鹕,戴着蓝帽子,披着红围巾,骑着一辆绿色自行车。车篮里还装着两条鱼,神情轻松,仿佛刚送完上一单,准备去海边接下一单。
构图、配色、细节都挺完整,至少没有出现 AI 绘图常见的肢体事故。
我盯着画面看了一会儿,心想这回 Google 可能真的有点东西。
再看看那只鹈鹕,一脸春风得意。
连一只鸟都能骑车上班了,我还有什么理由不努力?
于是,我决定不努力了。
让 Argon 替我干活。
一个 Goal,两个字:没了
当时的想法很简单:既然模型这么强,干脆找个真正有难度的任务,看看它能不能帮我省点时间。
我认真整理了要求,写了一份 Goal,选择 Argon High,交给 Antigravity 跑。
这次不是让它随便生成几行代码,而是需要理解上下文、研究资料、做出判断,再把工作完整交付。
我对它的期待还挺高。
然后它开始工作了。
努力地工作。
持续地工作。
我甚至一度产生了某种错觉:这位新来的同事虽然不怎么说话,但看起来挺勤奋,应该靠得住。
等它终于跑完,我迫不及待地去看成果。
怎么说呢。
如果这是一份外包交付,我大概会礼貌地回复一句:“辛苦了,我们再研究研究。”
翻译成人话,就是还得重做。
更精彩的还在后面。
我顺手看了一眼 Antigravity 的用量提示。
Weekly usage,用完了。
……
好家伙。
Codex 的周额度还没恢复,刚买的 Gemini Pro 又把自己的周额度跑完了。
两个 AI 工具,一个等恢复,一个也等恢复。
我花钱买了一堆生产力,最后成功实现了带薪休假。
只可惜放假的是 AI,不是我。
事后查了一下 /goal 的机制,才发现它本来就没有固定的迭代次数上限。只要认为目标还没完成,就可能继续检查、修改、重试。
这设计本身没什么问题,碰上边界清楚、验收标准明确的工程任务,说不定非常好用。
但我这次交付的要求里,有不少事情依赖判断和质量取舍,并不是跑通测试就算完事。
想想也挺荒谬的。
我原本希望它能替我省时间,结果它花了大量额度,替我证明了这件事没那么容易。
当然,这笔账不能全算在 Argon 头上。任务拆分、执行模式、验收条件,都可能有问题。
不过我现在至少确定了一件事:
以后再看到 /goal,得先确认一下自己还剩多少额度。
不然哪天让它帮忙修个小问题,回来发现它顺手把整个项目重构了,问题还在,额度没了。
那到底还用不用 Argon?
用,当然用。
年费都付了,现在放弃,岂不是显得我早上那个决定真的很草率?
只是暂时还不会让它直接接管大型任务。
这段时间用下来,GPT-6.1 Sol XH 仍然是我比较信任的主力。遇到复杂的工程问题,它对上下文的理解、架构的把握,以及持续推进任务的能力,整体感觉更稳。
也不是不会犯错。只不过它出错的时候,我通常还能理解它想干什么。
这点其实很重要。
Opus 5.5 High 也很不错,有些任务的处理甚至相当漂亮。问题是 usage 消耗得实在太快。
每次用它,都像拿着非洲的工资,跑到苏黎世打车。司机一路开得很稳,我却盯着计价器心惊肉跳,甚至开始认真思考:目的地真的有必要去吗?
Grok 4.7 就比较适合接手一些零碎活。便宜大碗,要求不太高的事情交给它,通常也能做。
偶尔犯点蠢,就当是办公室里那位工作态度不错、但需要有人帮忙检查的同事。
至于 Argon,目前还不好说。
鹈鹕测试的表现确实让我惊喜,但后面那个大型任务,又让我有点摸不着头脑。
也许是我的使用方式不对,也许是任务刚好踩中了它的弱点。新模型才用这么几次就下结论,多少有点冤枉人家。
等额度恢复,再找几个不同类型的任务试试。
这回会先从小一点的开始。
最后,说点不那么好笑的
以前写代码,遇到问题要自己查资料、读文档、想办法。
现在很多事情确实能交给 AI,效率比以前高了不少。但随之而来的,是另一种麻烦:你得学会判断什么事情适合交给谁,该给多少自由度,以及什么时候应该叫停。
有时候看着 Agent 一路执行,过程相当热闹,最后却还是得自己收拾残局。
最令人沮丧的并不是它做错了。
而是它很努力地做错了。
代码改了一大堆,日志刷了满屏,任务清单一项项打勾。看到最后,还真有点不好意思说它没做好。
可惜,工作不是看谁比较辛苦。
我也不太在意哪个模型又拿了什么 Benchmark 第一名。排行榜可以参考,真正用起来是另一回事。尤其当一个任务需要连续工作好几个小时,模型能不能稳定完成,比偶尔秀一次神操作更重要。
这次使用 Argon,说不上满意,但也谈不上失望。
毕竟才刚开始,而且说真的,如果不是自己手痒,非要一上来就把大型 Goal 丢给它,也不至于这么快用完额度。
算是花钱买了个教训。
反正会员还有一年,时间多得很。
现在那只鹈鹕还在图片里骑自行车,戴着帽子,吹着海风,笑得相当灿烂。
我看着它,突然有点羡慕。
至少它不用等 weekly reset。
完