Together AI 推出 Together Compiler,利用智能体持续优化推理性能最高提速 2.6 倍
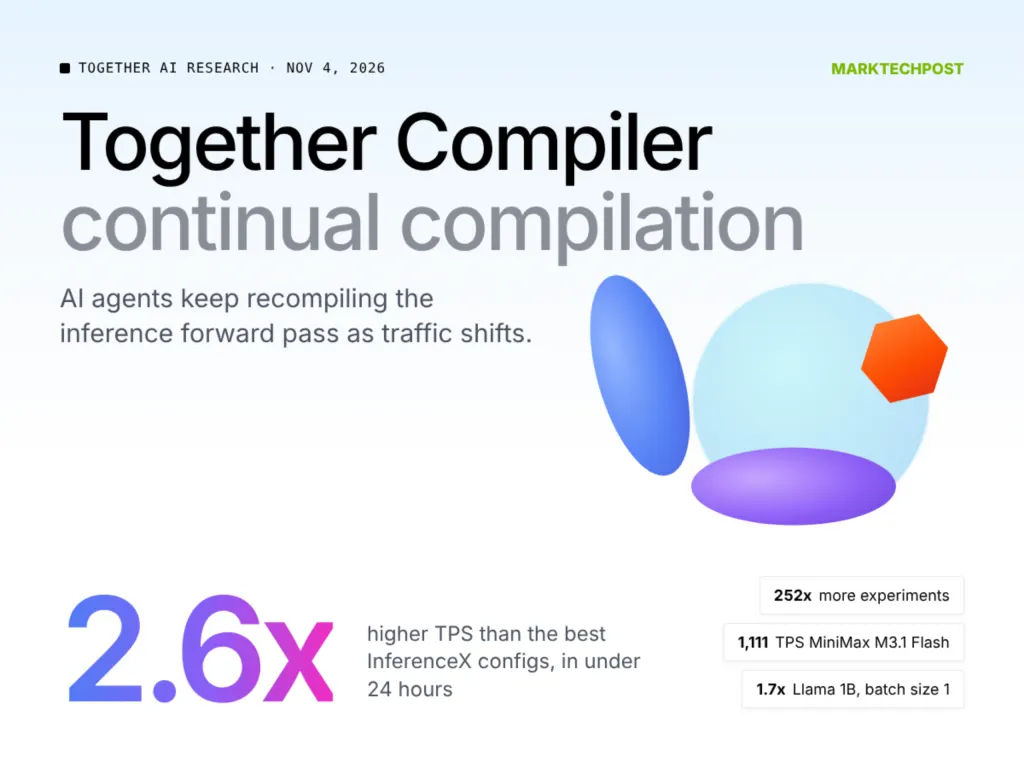
Together AI 近日推出了名为 Together Compiler 的新系统,该系统由智能体驱动,能够在生产流量发生变化时持续重新优化推理性能。目前该编译器已在 Together 的多个无服务器端点运行。开发者的核心主张是引擎一旦调优就会过时,因此调优工作不应停止。测试覆盖了 Kimi K3、GLM 5.3、MiniMax M3.1 Flash、DeepSeek v4.1 Flash 及 Llama 1B 等多个模型,支持 NVIDIA B200、B300、GB300、H100、AMD MI355X 以及 AWS Trainium2 等硬件。性能数据显示,其吞吐量最高比最佳发布的推理配置高出 2.6 倍,每个设置耗时不到 24 小时。在 MiniMax M3.1 Flash 模型上,B200 架构单批次模式下用户 P90 TPS 达到 1111,是基准线 633 的 1.8 倍。相比之下 GLM 5.3 在 MI355X 上的提升约为 4%。该系统通过编码智能体重写模型前向过程,结合启动命令、流量配置文件和硬件配置,由持久化引擎测量每个提议的前向过程,获胜代码将部署到服务引擎中。当流量发生漂移时,循环会再次运行以进行持续编译优化。
编号 NEWS-20803
分类人工智能
时间2026-11-05 18:48:40
相关10