英伟达模型GR00T 2先观看人类视频,再把自己想象成机器人
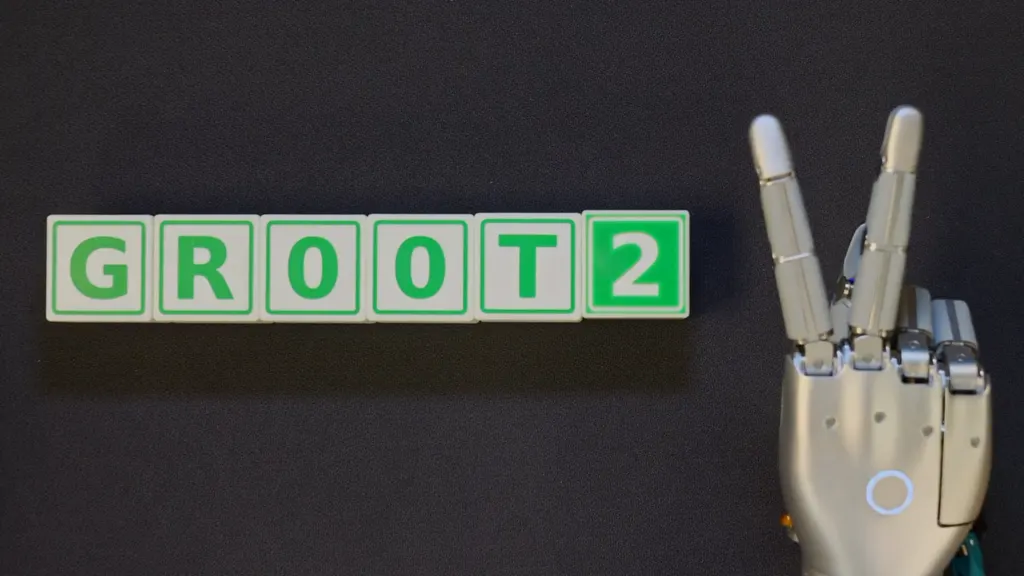
要让机器人学会新任务,通常需要人在训练中费力遥操作。英伟达新模型GR00T 2旨在把视频中的人类动作迁移到机械臂上,以减少投入。遥操作成本高、速度慢,而且每种机型都要单独采集数据。英伟达在新研究报告中推出这一基础模型以缩短该过程。与包括前代GR00T 1在内的以往方法不同,它不再把画面和语言指令直接转换成电机动作,也不再是视觉-语言-动作模型。英伟达称之为世界动作模型,会同时计算下一步动作,并用扩散模型生成一段即将发生情形的短视频,例如预测机械臂抓起物体时画面应如何变化。这种视频预测应能让模型在不同机器人形态之间迁移动作序列。英伟达在拥有一千多块GB300芯片的集群上训练该系统,数据包括约40万小时由佩戴头戴式摄像头的人员完成各类任务的视频。研究团队表示,要教机器人一项新任务,只需有人用数据手套、专用手部夹具或手指外骨骼演示步骤。这些记录与目标机器人的通用运动数据结合后,模型会在视频预测中生成机械臂而非人手,并据此得出控制指令。实验室测试中,一台五指灵巧手机器人以此方式点燃火柴、切开香蕉,或把包裹投到传送带上,且未针对这些任务做过遥操作。成功率因任务而异,约在10%至80%。系统还通过计算机仿真,仅凭一段人手动作视频学会了钉钉子。在50项仅用少量示例就已表现良好的任务上,不到三分钟的常规训练就把成功率从40%提高到95%。对于更长的装配工作,英伟达把它与更上层的语言模型搭配,例如OpenAI的GPT-6 Astra。GR00T 2负责抓取,语言模型则把任务拆成步骤,在画面中用颜色标出抓取点,并在零件掉落时启动辅助程序。研究人员把玩具模型散件无序放在桌上时,组合系统在至少97%的试验中完成装配;若没有纠正用的语言模型和额外微调,玩具车装配在100次尝试中仅成功23次。团队还在真实设备上通过反复试错训练了插网线或充电器等精细任务。针对双足机器人,英伟达开发了处理图像细节更少的精简版GR00T 2 Turbo,可直接在人形机器人的Jetson Thor板载计算机上运行。测试中,机器能够舀爆米花、清理桌面,并用脚边的毛巾擦掉液体,不过最后一项任务成功率略低于一半。研究团队指出,要可靠用于真实环境仍有明显障碍:模型尚不能处理直接触觉数据,有时会漏掉螺丝只拧到一半这类细微错误。上层语言模型也会拖慢节奏。在垃圾分拣测试中,机器人约有三分之一时间在等待,因为规划模型下一次计算平均要花七秒以上。
编号 NEWS-21257