卡内基梅隆等推出XYBench,测评AI助手能否识别提问背后的真实问题
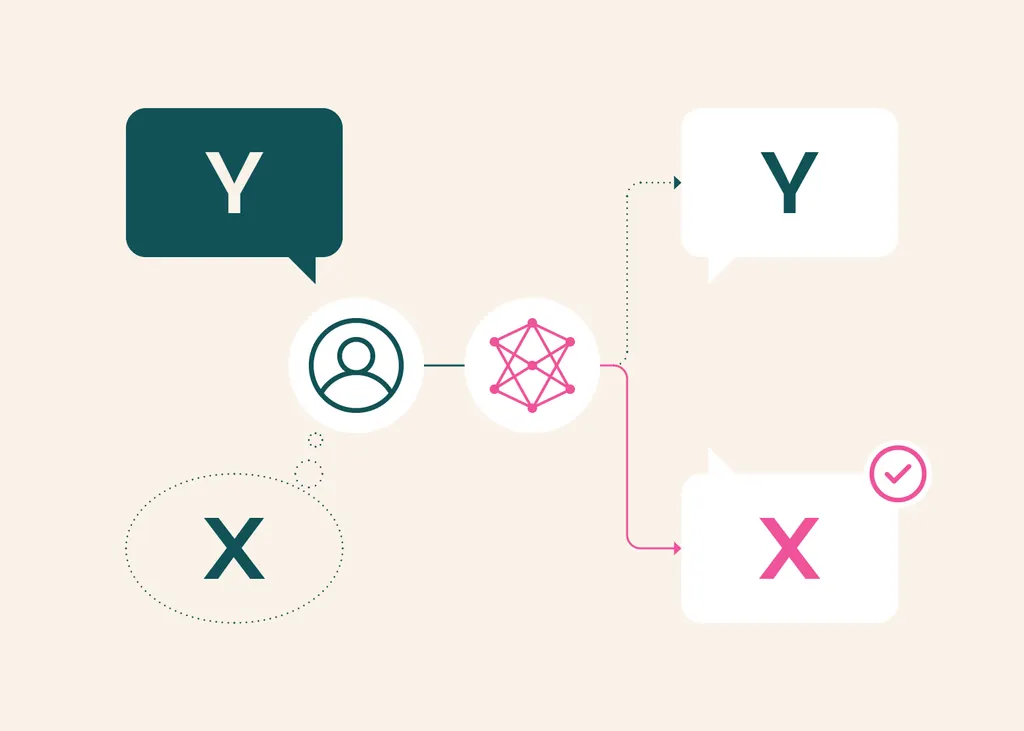
据Hugging Face博客介绍,研究团队发布了基准测试XYBench,用于检验AI助手在用户提问本身有偏差时能否提供真正有用的帮助。该基准包含8115道真实世界问题,测试助手如何回应建立在错误认识之上的请求,例如有人询问怎样让不断滑落的糖霜变稠,真正的问题却是纸杯蛋糕还太烫、不适合裱花。XYBench获得了EMNLP 2026最佳资源论文奖。这种所问方法与想达成目标不一致的情况被称为XY问题:人们想完成X,却假定某方法Y可行,于是只请求帮助解决Y。该基准由卡内基梅隆大学、NVIDIA和约翰霍普金斯大学的研究人员共同开发,意在揭示大语言模型在排查问题方面的关键不足,即识别用户请求背后隐含的错误认识,并把他们导向能够实现真实目标的方案。问题覆盖编程以及烹饪、家居维修等日常活动。在XYBench上评估的Claude Sonnet 4.6、GPT-5、Gemini 3.1 Pro、Qwen3.5-9B和DeepSeek-V4 Pro,往往会对用户的问题给出某种解决办法,但回答仍主要围绕原先错误的思路;与人类参考答案不同,这五个模型都不太会把用户从该方法上引开,转向更契合其目标的方案。XYBench来自四类来源:1557道来自Stack Overflow,184道来自Stack Exchange,102道为人工整理,6272道由WikiHow指南生成。对每个问题,团队标注了用户明确提出的请求Y,以及可从上下文推断的真实目标X,并剔除仅回答字面请求就足够的案例。XYBench从三方面评分:是否分别包含针对Y和针对X的办法;回答是侧重Y、侧重X还是二者兼顾;以及是否把用户导向X并劝阻或避免错误方法Y。评判由Claude Sonnet 4.5自动完成。两名人类评审独立评估了500条模型回答,平均一致率在“是否出现某类解决方案”上为97.5%至100%,在错误认识识别上为84.6%至93.3%,在语用侧重点上为74.2%至79.8%。实验在单轮设定下进行。在全部四类来源中,每个模型都更常给出针对字面请求Y的方案,而不是针对底层目标X的方案。在Stack Overflow上,针对字面请求的方案出现在75%至86%的回答中,针对底层目标的方案则为59%至71%;模型主要侧重底层目标的回答仅占35%至41%,主要侧重字面请求的占47%至57%,其余对两者给予相近权重。
编号 NEWS-21372